

教程#
备注
本教程与 NVIDIA Sim-to-Real SO-101 学习课程 及其 工作坊仓库 相衔接。课程使用 SO-101、Isaac Lab 和 NVIDIA Isaac GR00T,介绍更完整的端到端物理 AI 工作流程。
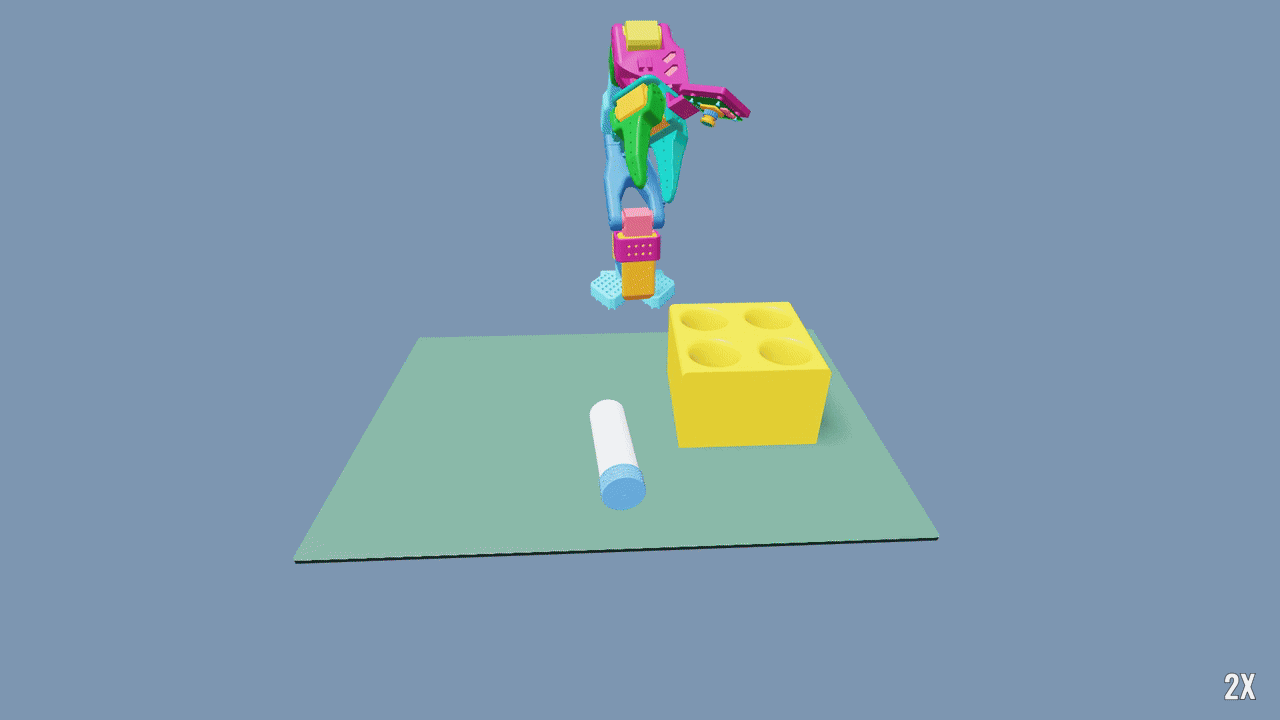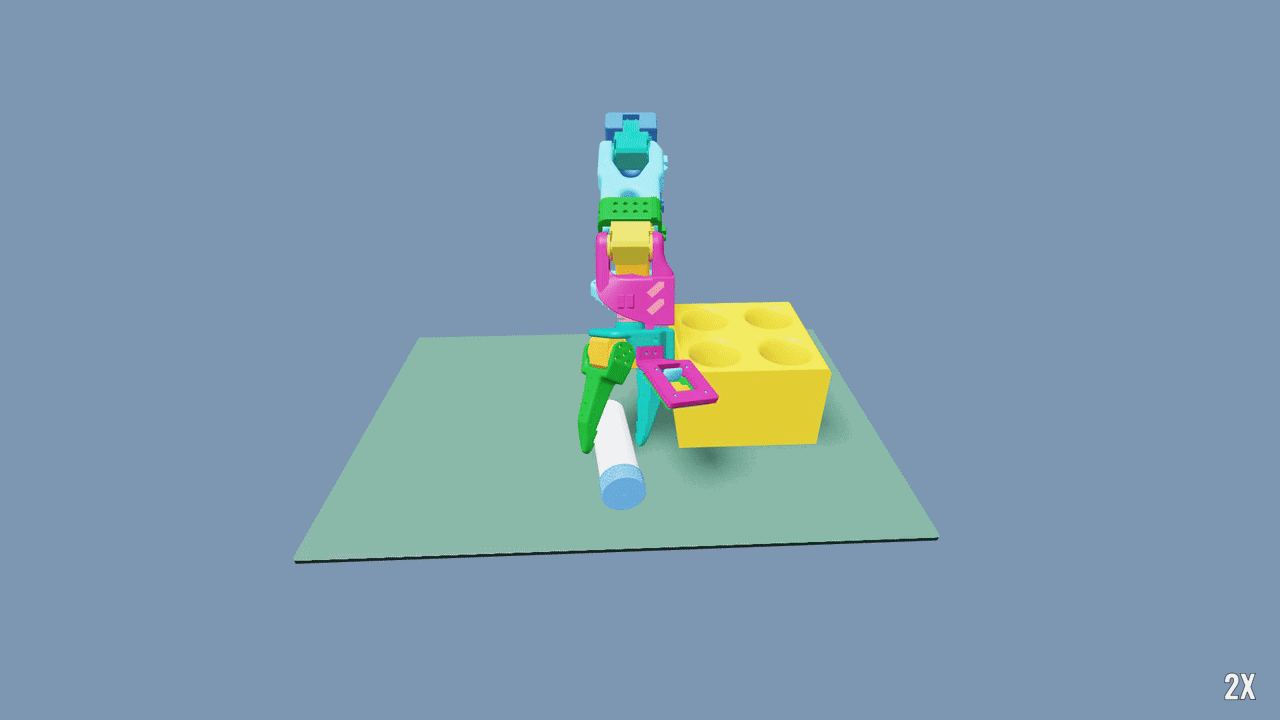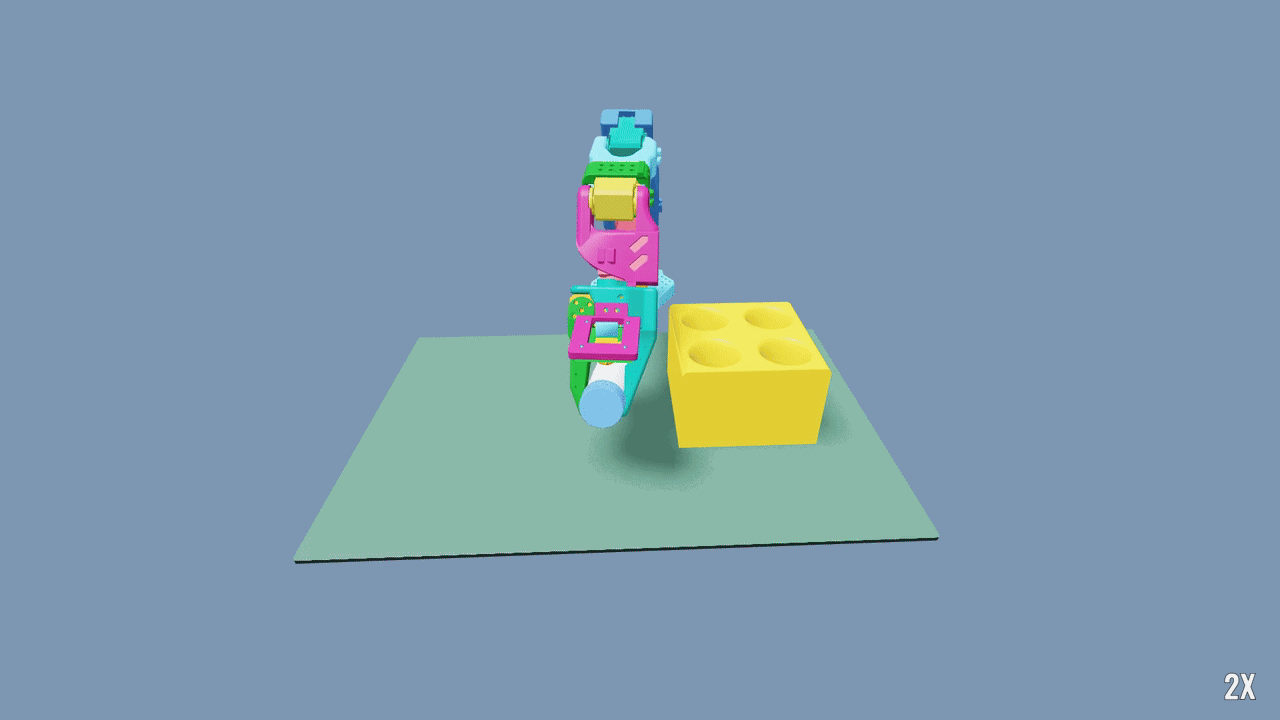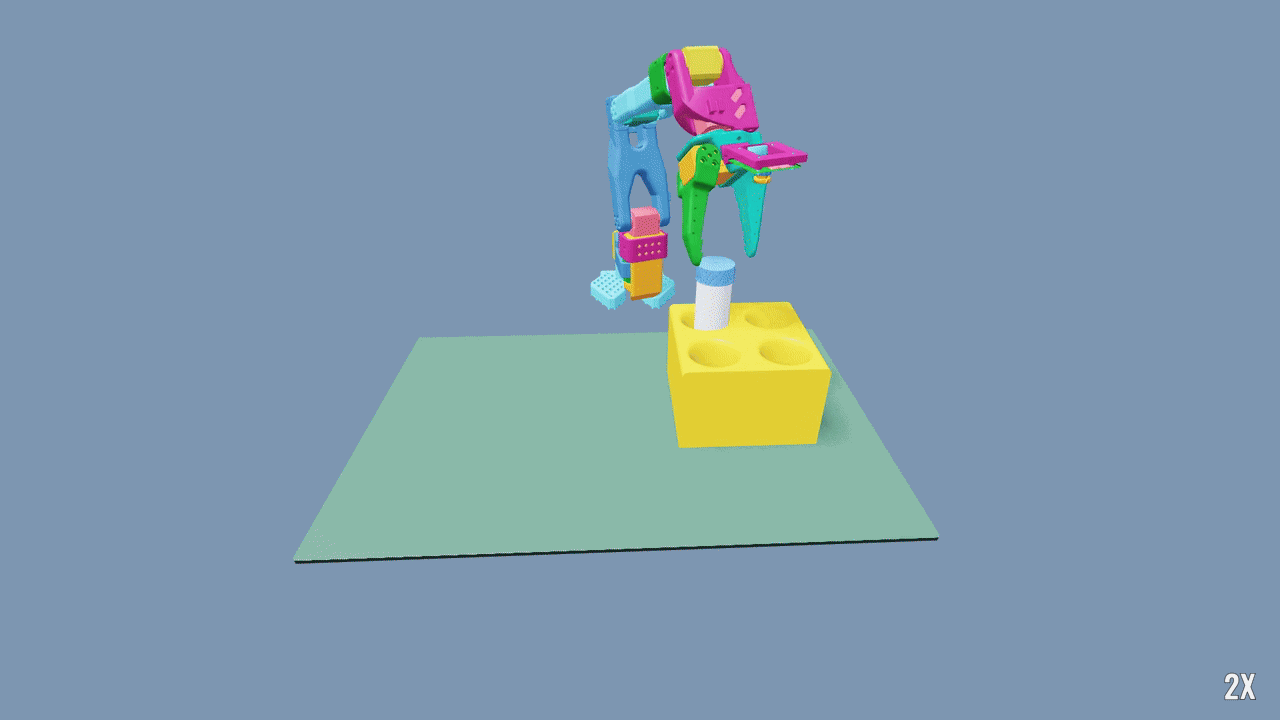
本教程围绕 SO-101 机械臂 拾取样品瓶并放入支架的任务,构建完整的机器人学习流程。你将使用一个接近实际项目组织方式的下游项目: IsaacLabTutorial 的 main 分支 ,而不是拼接彼此独立的示例。项目包含机器人和工作坊资源、基于管理器的强化学习环境、状态与腕部相机观测、RSL-RL 智能体配置、测试、状态策略训练,以及从状态策略到视觉策略的蒸馏。
完成本教程后,你将了解下游 Isaac Lab 任务如何打包、被发现、验证、训练和评估,也会知道如何修改机器人、场景、MDP 和学习配置,以实现自己的任务。
1. 配置项目#
你需要 Python 3.12、 uv 、Git 和 NVIDIA GPU。本教程使用 Newton 的 MJWarp 求解器,主要流程无需 Isaac Sim 应用程序。开始前,请检查 系统要求 。
克隆教程的 main 分支并创建环境:
git clone https://github.com/isaac-sim/IsaacLabTutorial.git
cd IsaacLabTutorial
uv sync
项目通过 pyproject.toml 固定使用 Isaac Lab 的 develop 分支,因此无需在旁边克隆 Isaac Lab 仓库。 uv sync 会创建环境,并安装教程项目、Isaac Lab 及其运行时依赖。
此仓库也是 Isaac Lab 模板生成器 所生成下游项目的完整示例。创建自己的项目时,可使用模板生成器,再沿用此处的包布局和任务发现方式。
确认统一 CLI 能发现下游软件包:
uv run isaaclab --help
uv run python -c 'import importlib.metadata; print([e.name for e in importlib.metadata.entry_points(group="isaaclab.tasks")])'
第二条命令的输出应包含 so101-vial-place 。项目通过发布 isaaclab.tasks 入口点实现任务发现:
[project.entry-points."isaaclab.tasks"]
so101-vial-place = "isaaclab_tutorial.tasks"
导入该软件包时,会注册三个 Gymnasium 任务 ID:
任务 ID |
策略观测 |
|---|---|
|
机器人、样品瓶、支架、放置情况和任务进度的状态 |
|
使用 64 × 48 腕部 RGB 图像和本体感知信息,从头进行 PPO 训练 |
|
从状态策略蒸馏视觉策略,使用与部署时相同的相机观测 |
小技巧
后续命令均在 IsaacLabTutorial 目录中运行。先训练基于状态的任务:它既是基线,也为蒸馏任务提供教师检查点。
2. 浏览项目#
项目将可复用的任务逻辑与 SO-101 专用配置分开:
IsaacLabTutorial/
|-- pyproject.toml                     package metadata and task-discovery entry point
|-- media/                              reference rollout
|-- src/isaaclab_tutorial/
|   |-- assets/                        workshop and reset-pose data
|   |-- tasks/place_vial/
|   |   |-- mdp/                       actions, events, observations, rewards, and progress logic
|   |   |-- reset/                     reset dataset, curriculum, and generation logic
|   |   `-- config/so101/
|   |       |-- __init__.py            Gymnasium task registration
|   |       |-- env_cfg.py             scene, MDP, and physics configuration
|   |       |-- camera_env_cfg.py      wrist-camera task variant
|   |       `-- agents/                PPO and distillation configurations and models
|   `-- utils/                         exact rollout evaluation helpers
`-- tests/                              behavioral and configuration contracts
这样的划分是有意设计的。添加新机器人时,创建与 config/so101 并列的目录,并复用样品瓶放置任务的 MDP;添加不同的操作任务时,创建与 tasks/place_vial 并列的目录,由新任务管理自己的任务项。
注册将任务 ID 与通用的基于管理器环境、任务配置和默认 RSL-RL 智能体连接起来:
gym.register(
    id="IsaacTutorial-Place-Vial-SO101",
    entry_point="isaaclab.envs:ManagerBasedRLEnv",
    disable_env_checker=True,
    kwargs={
        "env_cfg_entry_point": f"{_PACKAGE}.env_cfg:SO101VialEnvCfg",
        "rsl_rl_cfg_entry_point": f"{agents.__name__}.rsl_rl_ppo_cfg:SO101StatePPORunnerCfg",
        "default_agent": "rsl_rl",
    },
)
因此,无需项目专用的启动脚本,常规 isaaclab train 、 play 和 benchmark 命令就能运行这些任务。
3. 理解任务#
环境通过 ManagerBasedRLEnvCfg 以声明式方式组装。主配置关联一个场景配置,以及各个 MDP 管理器的配置:
@configclass
class SO101VialEnvCfg(ManagerBasedRLEnvCfg):
    scene = SO101SceneCfg(num_envs=4096, env_spacing=0.9, replicate_physics=True)
    actions = ActionsCfg()
    observations = ObservationsCfg()
    events = DatasetEventsCfg()
    rewards = RewardsCfg()
    terminations = TerminationsCfg()

    def __post_init__(self):
        self.decimation = 4
        self.episode_length_s = 20.0
        self.is_finite_horizon = False
        self.sim.dt = 1.0 / 120.0
        self.sim.physics = PhysicsCfg()
仿真频率为 120 Hz,控制降采样倍数为 4,因此策略控制频率为 30 Hz。 replicate_physics=True 使相同场景能够扩展到数千个环境。
场景与控制#
SO101SceneCfg 包含固定基座的 SO-101、自由运动的 20 g 样品瓶、支架、碰撞垫、两个夹爪指和样品瓶上的接触传感器,以及穹顶光源。机器人配置、经过辨识的执行器动力学及限制均来自 Isaac Lab 的 SO101_CFG 。
六维策略动作包含五个有界的机械臂关节相对位置增量,以及一个有界的夹爪相对增量。任务不会将样品瓶附着到夹爪上,也不会在重置后直接写入样品瓶位姿。因此,抓取、搬运、插入和松开都必须通过仿真的接触作用完成。
MDP 概览#
组件 |
约定 |
|---|---|
动作 |
五个机械臂关节增量,每个控制步按 0.033 rad 缩放,以及一个夹爪增量。 |
基于状态的 Actor |
关节状态与目标、上一动作、末端执行器状态、样品瓶状态、相对支架的目标、放置特征,以及不可逆的进度标志。 |
基于相机的 Actor |
不包含物体状态:使用经过随机化的 64 × 48 腕部 RGB 图像,以及含噪声的关节状态、目标和上一动作。 |
Critic |
特权状态观测和物理接触状态。 |
事件 |
采样重置位姿,并对样品瓶质量和摩擦进行小幅随机化。 |
奖励 |
少量物体到目标的奖励塑形项、物理进度节点奖励、成功奖励、丢失惩罚,以及较小的动作变化率和关节速度代价。 |
终止条件 |
放置成功、样品瓶丢失、机器人状态不稳定,或达到 20 s 时间上限。 |
物理进度与重置#
仅从桌面初始位姿开始,长时程操作任务很难学会。因此,项目在八个阶段中复用经过物理验证的重置位姿:
home -> pregrasp -> grasp -> lift -> reorient -> transport -> insert -> release
训练时,将这些阶段作为重置课程进行采样。每个阶段仍属于同一个任务,观测、动作、奖励和终止条件保持不变。只有出现物理证据时,进度标志才会推进,例如在预期抓取点附近检测到两侧夹爪接触,并测得能够承载样品瓶的抬升。交互式策略运行会回到第零阶段的起始状态,因此最终策略必须完成整个任务。
实际启用的奖励项刻意保持精简。大多数候选塑形项仍保留在配置中,但权重设为零,便于复现实验,避免将行为隐藏在临时代码里。物理判定条件见 mdp/terms.py ,重置分布见 reset/curriculum.py 。
状态策略与相机策略#
SO101VialEnvCfg 是完全可观测的基线。 SO101VialCameraEnvCfg 继承该配置,添加腕部相机,并仅替换 Actor 的观测;其非对称 Critic 在直接 PPO 训练期间仍保留完整状态。 SO101VialCameraDistillationEnvCfg 还提供基于状态的教师策略和仅用于训练的几何目标;部署时的学生策略仍只接收腕部 RGB 图像和本体感知信息。
4. 训练前验证#
先运行快速检查,在长时间 GPU 训练之前发现资源、注册、几何、奖励、重置数据和配置约定中的问题:
uv run pytest -q
uv run ruff check .
接着,构建一个小规模向量化环境,施加零动作并执行步进:
uv run isaaclab zero_agent \
  --task IsaacTutorial-Place-Vial-SO101 \
  --num_envs 8 --visualizer none presets=newton_mjwarp
如果检查失败,请先修复任务发现、资源加载或仿真稳定性问题,再调整强化学习。如果检查通过,则独立于学习算法测量环境性能:
uv run isaaclab benchmark runtime \
  --task IsaacTutorial-Place-Vial-SO101 \
  --num_envs 4096 --num_steps 1000 --warmup_steps 50 \
  --visualizer none presets=newton_mjwarp
如果当前 GPU 无法容纳该批次,请减小 --num_envs 。对于相机任务,添加 Newton 渲染器预设,并从较小批次开始:
uv run isaaclab benchmark runtime \
  --task IsaacTutorial-Place-Vial-SO101-Camera \
  --num_envs 1024 --num_steps 1000 --warmup_steps 50 \
  --visualizer none presets=newton_mjwarp,newton_renderer
5. 训练与评估#
使用 RSL-RL 训练基于状态的教师策略。任务的默认智能体配置运行 800 次迭代:
CUDA_VISIBLE_DEVICES=0 uv run isaaclab train --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101 \
  --num_envs 4096 --max_iterations 800 --seed 42 \
  --run_name so101_vial_seed42 --device cuda:0 \
  --visualizer none presets=newton_mjwarp
检查点和 TensorBoard 事件写入 logs/rsl_rl/so101_vial_state/<run> 下,最终检查点为 model_799.pt 。训练期间,可在另一个终端中查看学习曲线:
uv run tensorboard --logdir logs/rsl_rl/so101_vial_state
除了奖励,还要关注回合完成指标是否上升。奖励塑形可能使回报增加,却未必提高样品瓶成功松开放置的比例。
运行状态教师策略#
从标准初始阶段运行已训练的教师策略:
uv run isaaclab play --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101 \
  --num_envs 1 --checkpoint /path/to/state_model.pt --deterministic \
  --visualizer newton_gl presets=newton_mjwarp
策略轨迹应从标准初始阶段开始,拾取横放的样品瓶,将其转为竖直,移到目标孔上方,插入孔中,最后打开夹爪,让样品瓶在重力作用下落座到支架中。
蒸馏腕部相机策略#
将训练完成的教师策略传入专门的蒸馏任务。学生策略使用腕部 RGB 观测,因此需要添加渲染器预设:
CUDA_VISIBLE_DEVICES=0 uv run isaaclab train --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101-Camera-Distillation \
  --num_envs 1024 --max_iterations 800 --seed 42 \
  --checkpoint /path/to/state_teacher.pt \
  --run_name wrist_distillation_seed42 --device cuda:0 \
  --visualizer none presets=newton_mjwarp,newton_renderer
蒸馏使用单 GPU。有界回放 DAgger 运行器从教师轨迹开始,逐步加入学生策略的恢复状态,并始终保持至少 25% 的教师动作比例。仅用于训练的几何预测头提供密集的定位目标,稀疏随机权重平均则提高最终检查点的稳定性。输出写入 logs/rsl_rl/so101_vial_camera_distillation/<run> 下。
使用与训练时相同的任务 ID 运行蒸馏后的学生策略:
uv run isaaclab play --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101-Camera-Distillation \
  --num_envs 1 --checkpoint /path/to/distilled_model.pt --deterministic \
  --visualizer newton_gl presets=newton_mjwarp,newton_renderer
评估策略#
一段看起来成功的运行轨迹不能代替评估。通过项目的外部回调,以无界面方式运行已记录的第零阶段起始状态集合:
uv run isaaclab play --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101 \
  --num_envs 1024 --checkpoint /path/to/state_model.pt --deterministic \
  --external_callback isaaclab_tutorial.utils.evaluation.install_episode_counter \
  --visualizer none presets=newton_mjwarp
对蒸馏后的策略使用相同的 1024 个起始状态评估约定:
uv run isaaclab play --rl_library rsl_rl \
  --task IsaacTutorial-Place-Vial-SO101-Camera-Distillation \
  --num_envs 1024 --checkpoint /path/to/distilled_model.pt --deterministic \
  --external_callback isaaclab_tutorial.utils.evaluation.install_episode_counter \
  --visualizer none presets=newton_mjwarp,newton_renderer
回调会对每个已记录的起始状态运行一次,并输出一条 SO101_EVAL_RESULT JSON 记录。比较实验时,请保存此记录、检查点、随机种子、任务 ID 和解析后的配置。作为参考,教程 main 分支报告的状态教师策略成功率为 99.4%;对蒸馏策略重复验证时,成功率为 67.6%–72.9%,且没有不安全的支架接触。
维护重置数据集#
仓库中的重置数据集可直接用于训练。可以另行生成或检查候选数据集,而不覆盖现有数据:
uv run generate-so101-resets \
  --output checkpoints/reset_poses.pt --device cuda:0 \
  --visualizer none presets=newton_mjwarp

uv run view-so101-resets \
  --dataset checkpoints/reset_poses.pt --device cuda:0 \
  --visualizer newton_gl presets=newton_mjwarp
6. 改造为自己的任务#
每次只修改一个模块边界,并在训练前重新运行测试、零动作智能体检查和性能测试:
目标 |
修改位置 |
|---|---|
修改场景或 SO-101 |
|
修改 Actor 输入 |
|
修改任务行为 |
|
修改重置覆盖范围 |
|
修改 PPO 或蒸馏 |
|
添加其他机器人 |
添加 |
添加其他操作任务 |
创建与 |
任务演进过程中,应保持以下约定:
任务 ID 通过软件包入口点解析,不要复制 Isaac Lab 的启动脚本。
策略动作的顺序和缩放比例与机器人命令约定一致。
物理量和四元数遵循 Isaac Lab 当前的约定;Isaac Lab 3 使用 XYZW 四元数顺序。
重置生成有效的物理状态,重置后的任务代码不直接瞬移被操作物体。
成功条件要求样品瓶已经松开并在支架中正确落座,不能仅以靠近支架作为成功。
测试应覆盖可观测的任务约定,性能测试则检查改动是否将高开销操作移入了每个环境的步进循环。
接下来,可通过 任务设计流程 了解管理器式与直接式架构,通过 强化学习 了解框架细节,通过 Hydra 配置系统 了解命令行覆盖配置的方法。