

强化学习#
使用 train 和 play,即可通过任一受支持的强化学习(RL)库训练和评估策略。
如果正在开始一个新的机器人项目,且不需要其他库的独有功能,建议从 RSL-RL 开始。
快速入门#
在 Isaac Lab 仓库中,使用 RSL-RL 训练 Cartpole 策略:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole
训练默认以无界面模式运行,并将检查点和 TensorBoard 日志写入 logs/rsl_rl/ 。
在交互式可视化器中评估最新的兼容检查点:
uv run isaaclab play --rl_library rsl_rl --task Isaac-Cartpole \
    --checkpoint latest --num_envs 32 --viz newton_gl
train 和 play 命令适用于所有受支持的强化学习库。
无需安装 Isaac Lab,即可在 交互演示库 中体验预训练的 Cartpole、G1 和 ANYmal-D 控制器。这些精简的浏览器场景用于展示策略控制;完整的任务评估仍应使用原生策略回放。
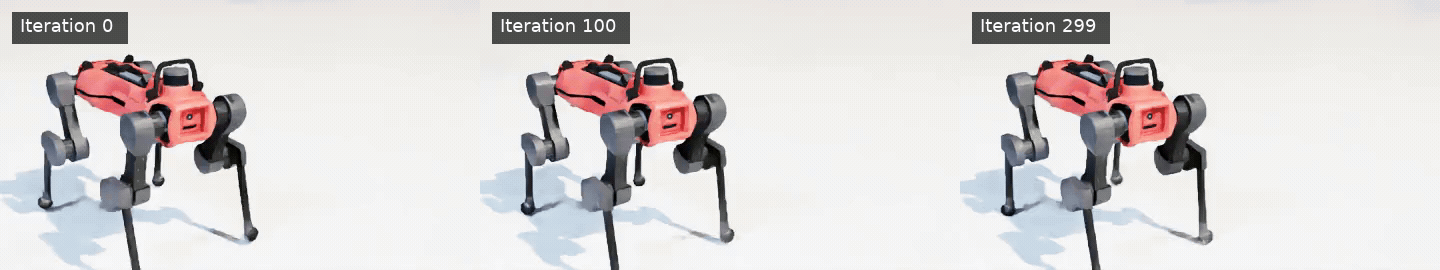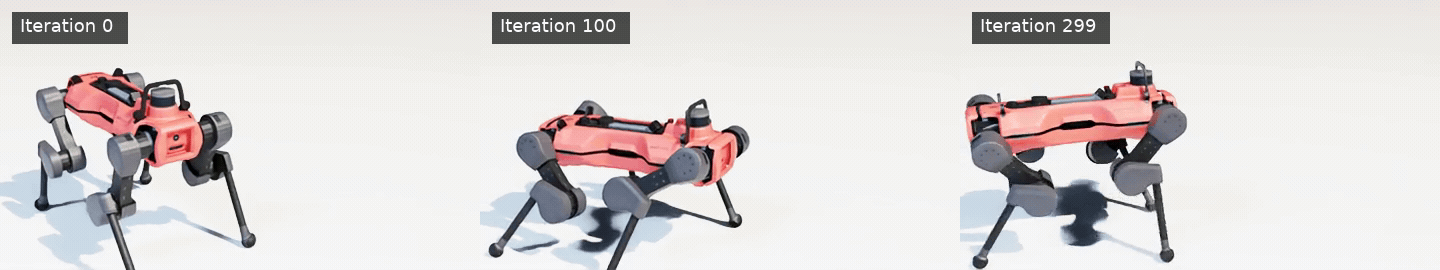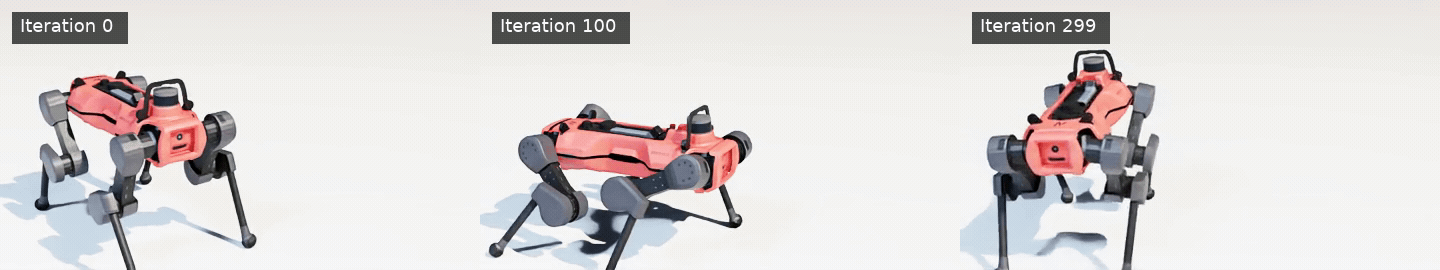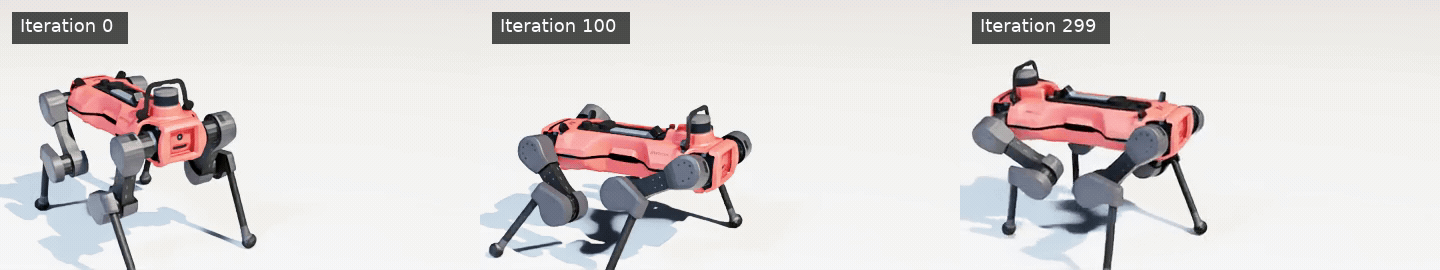
ANYmal-D 运动策略在训练期间三个检查点上的表现。#
选择强化学习库#
根据实验需要的算法和配置工具选择强化学习库。
库 |
适用场景 |
在 Isaac Lab 中的主要功能 |
安装 |
|---|---|---|---|
RSL-RL |
大多数 GPU 并行运动和操作任务 |
PPO、教师-学生蒸馏、对称性增强、随机网络蒸馏,以及循环策略和基于 CNN 的策略 |
默认包含 |
skrl |
JAX 工作流程或显式多智能体训练 |
基于 PyTorch 或 JAX 的 PPO、AMP、IPPO 和 MAPPO |
PyTorch 使用 |
RL-Games |
已有 RL-Games 项目或基于种群的工作流程 |
PPO、SAC、A2C、基于种群的训练、分布式训练和 Ray 集成 |
|
Stable-Baselines3 |
常用基线及 Stable-Baselines3 生态工具 |
PPO,以及 Stable-Baselines3 的回调、日志和模型 API;更适合小规模实验 |
|
RLinf |
视觉-语言-动作模型的强化学习微调 |
通过 Ray 和 FSDP 进行分布式 GR00T 与 OpenVLA 后训练 |
需要专门配置 |
TorchRL |
基于 PyTorch 原生强化学习组件构建自定义算法 |
基于 |
|
运行命令时,选择对应的 uv extra 来安装可选依赖:
uv run --extra skrl isaaclab train --rl_library skrl --task Isaac-Cartpole
uv run --extra skrl-jax isaaclab train --rl_library skrl --task Isaac-Cartpole --ml_framework jax
uv run --extra rl-games isaaclab train --rl_library rl_games --task Isaac-Cartpole
uv run --extra sb3 isaaclab train --rl_library sb3 --task Isaac-Cartpole
uv run --extra torchrl isaaclab train --rl_library torchrl --task Isaac-Cartpole
uv run --extra torchrl isaaclab play --rl_library torchrl --task Isaac-Cartpole --checkpoint latest
典型训练流程#
开始长时间训练前,先用小规模冒烟测试验证环境和完整训练路径。
首先,不使用强化学习库,检查任务能否正常重置和步进:
uv run isaaclab random_agent --task Isaac-Cartpole --num_envs 16
然后,在少量环境上运行几次训练迭代:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    --num_envs 64 --max_iterations 10
两个命令都成功后,移除冒烟测试的覆盖参数,使用任务调好的默认值。
记录训练进度#
使用 TensorBoard 查看本地运行结果,或通过 Weights & Biases(W&B) 在线跟踪实验并与团队比较结果。日志由强化学习库配置,因此不同运行器的选项有所区别。
TensorBoard。 RSL-RL 默认将 TensorBoard 日志写入 logs/rsl_rl/。在另一个终端启动仪表盘:
uv run python -m tensorboard.main --logdir logs
打开 http://localhost:6006。使用 logs 可包含所有库的运行记录,使用 --logdir logs/rsl_rl 则仅查看 RSL-RL。RL-Games、Stable-Baselines3 和 TorchRL 运行器也会写入 TensorBoard 日志。skrl 的日志频率由 agent.experiment.write_interval 控制:auto 启用定期记录,0 禁用记录。
Weights & Biases。 添加 wandb extra,登录后在启动运行时选择 W&B。以 RSL-RL 为例:
uv run --extra wandb wandb login
uv run --extra wandb isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    --logger wandb --log_project_name isaaclab --run_name cartpole_baseline
为运行起一个便于辨认的名称,以便在仪表盘中区分实验。其他运行器使用各自的跟踪选项:
库 |
W&B 配置 |
|---|---|
RSL-RL |
|
RL-Games |
|
skrl |
在智能体配置中将 |
必要时,在使用 --extra wandb 的同时保留所用库的 extra,例如 uv run --extra rl-games --extra wandb isaaclab train ...。随项目提供的 SB3 和 TorchRL 运行器使用 TensorBoard,不提供 W&B 命令行开关。
RSL-RL 还提供 --logger neptune --log_project_name <project>,需要在训练环境中安装 neptune-client 并配置 Neptune 凭据。
关注哪些指标。 应着重观察多个迭代中的趋势:
平均奖励 通常应逐步提高,但其绝对值取决于任务。
平均回合长度 取决于任务。平衡任务中较长回合通常有益,但目标完成任务未必如此。
吞吐量 有助于在调整环境数量、传感器或渲染后识别系统瓶颈。
损失、熵、KL 散度和动作标准差 有助于发现更新不稳定或探索停滞。具体指标名称因库而异。
评估策略#
使用 play ,并选择下列检查点选择器之一:
选择器 |
行为 |
|---|---|
|
从最新的兼容本地运行中,加载步数最高的检查点。 |
|
如果库记录了最佳或最终检查点,则加载它;否则回退到 |
|
为受支持的任务和后端下载已发布检查点。 |
|
加载指定检查点。 |
例如,运行最佳本地检查点并录制短视频:
uv run --extra video isaaclab play --rl_library rsl_rl \
    --task Isaac-Cartpole --checkpoint best --video --video_length 200
提示
play 会调用环境配置的 play_mode() 方法,将场景限制为最多 50 个环境,并根据工作流程禁用观测噪声或扰动。可在任务配置中覆盖该方法,自定义回放行为。
预训练检查点#
部分核心任务及强化学习库/后端组合提供预训练检查点,社区贡献任务不在此列。
使用 --checkpoint pretrained 可加载与已解析的任务配置对应的公开策略。如果没有可用策略,命令会提示并退出。此时请在本地训练,再使用 latest 或显式检查点路径。
维护者可以使用 scripts/tools/train_and_publish_checkpoints.py 生成推荐的核心任务检查点矩阵。通过 --list --all --core ,可列出当前源代码计划发布的任务和后端组合。该矩阵不会实时检查远程资产存储;只有检查点上传后,列出的组合才能通过 --checkpoint pretrained 使用。
uv run python scripts/tools/train_and_publish_checkpoints.py \
    --list --all --core
恢复训练#
从最新兼容检查点恢复:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    --checkpoint latest
加载检查点时,应与原训练使用相同的任务、智能体、机器学习框架及观测/动作预设。
配置实验#
每个任务为其支持的库注册一个或多个智能体配置。建议从 source/isaaclab_tasks/isaaclab_tasks/<task-family>/.../agents/ 下最接近、持续维护的配置开始,而不是从零编写。
查找任务和智能体#
先列出已注册的任务,再查看任务专用帮助。列表包含 RL Libraries 列,因为每个任务只支持其已注册配置的强化学习库:
uv run isaaclab list_envs --show_presets
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole --help
通过 --agent 选择其他已注册配置。例如:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    --agent rsl_rl_with_symmetry_cfg_entry_point \
    --run_name ppo_with_symmetry
智能体配置格式因库而异:
RSL-RL 使用继承
RslRlBaseRunnerCfg的 Python 配置类。RL-Games、skrl 和 Stable-Baselines3 使用各库特有的字典或 YAML 文件。
RLinf 使用专门的 VLA 后训练配置。
任务提供多种观测或动作预设时,应选择网络与所选预设匹配的智能体。
提示
省略 --rl_library 时, train 和 play 加载任务注册的 default_agent 。大多数核心任务默认使用 RSL-RL;多智能体 Pendulum 任务默认使用 skrl。
通过 Hydra 覆盖配置#
在命令行选项后追加 Hydra 覆盖参数,可修改环境或智能体设置:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    --seed 2024 --run_name cartpole_seed_2024 \
    env.actions.joint_effort.scale=10.0 \
    agent.algorithm.learning_rate=0.0005
引号规则、列表值和多次运行的参数扫描,见 Hydra 配置系统 。
选择后端和预设#
任务可为物理、渲染、观测、动作及其他领域提供命名选择器。将不带前导短横线的选择器附加到命令后:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Cartpole \
    physics=newton_mjwarp

uv run isaaclab train --rl_library rsl_rl \
    --task Isaac-Cartpole-Camera-Direct \
    physics=newton_mjwarp renderer=newton_renderer presets=rgb
并非每个任务都支持所有后端。任务声明的预设见 后端与预设 。
重要
训练与策略播放应使用相同的物理、渲染器、域及观测/动作预设。更改观测或动作预设可能改变策略架构,导致检查点张量形状不匹配。
扩大训练规模#
--num_envs 设置并行环境数。增加环境数可以加快数据采集,直到仿真、优化或 GPU 显存成为瓶颈。
Isaac Lab 还支持 RSL-RL、RL-Games 和 skrl 的分布式训练。跨多 GPU 扩展训练的详情见 多 GPU 和多节点训练 。
专用工作流程#
这些工作流涵盖策略迁移、多智能体训练、JAX 和 VLA 后训练。
RSL-RL 蒸馏#
蒸馏将行为从训练好的 教师 策略传递到 学生 策略。学生学习复现教师的动作,通常使用不同的观测集合或更小的网络。当教师使用的信息在部署时无法获得,这种方法很有用。例如,可以先训练基于状态的策略,再将其蒸馏为基于视觉的策略。
首先训练教师:
uv run isaaclab train --rl_library rsl_rl \
    --task Isaac-Velocity-Flat-AnymalD
然后选择已注册的蒸馏智能体,并加载教师检查点:
uv run isaaclab train --rl_library rsl_rl \
    --task Isaac-Velocity-Flat-AnymalD \
    --agent rsl_rl_distillation_cfg_entry_point \
    --checkpoint /path/to/teacher.pt
任务和蒸馏配置决定教师与学生可获得的观测。请确保检查点由兼容的教师配置生成。
skrl 多智能体训练#
多智能体强化学习训练多个在同一环境中行动的智能体。skrl 支持两种常用方法:
MAPPO 在训练价值函数时使用所有智能体的信息,但运行时各智能体仅根据自身观测行动。这种集中训练、分散执行的方法有助于学习协调行为。
IPPO 独立训练各智能体。它更简单,是实用的基线,但优化时不会显式使用其他智能体的信息。
例如,使用 MAPPO 训练 Shadow Hand 物体交接任务:
uv run --extra skrl isaaclab train --rl_library skrl \
    --task Isaac-Shadow-Handover-Direct \
    --algorithm MAPPO
通过 --algorithm IPPO 运行对应的独立策略流程。所选任务必须提供算法支持的多智能体接口。
使用 JAX 进行 skrl 训练#
skrl 也可以使用 JAX 代替 PyTorch 训练策略,适合接入基于 JAX 的学习系统,或试验 JAX 编译与执行:
uv run --extra skrl-jax isaaclab train --rl_library skrl \
    --task Isaac-Reach-Franka \
    --ml_framework jax
备注
skrl-jax 可选依赖组会安装支持 CUDA 13 的 JAX 和 skrl 的 JAX 依赖。在此工作流程中,应使用它替代 skrl 可选依赖组。
JAX 默认会预分配 GPU 显存,因此需要确认可用显存能同时满足仿真和学习器的需求。更多信息见 skrl 安装指南 和 JAX 安装指南。
RLinf VLA 后训练#
视觉-语言-动作(VLA)模型将视觉观测和语言指令映射为机器人动作。RLinf 使用强化学习,将预训练 VLA 模型适配到具体任务,通过任务奖励而不只是示范数据改善其行为。
提供 RLinf 实验配置和待后训练的基础模型:
uv run --extra rlinf isaaclab train --rl_library rlinf \
    --config_name isaaclab_ppo_gr00t_assemble_trocar \
    --model_path /path/to/base_model
相比从零训练小型策略,VLA 后训练通常需要更多显存。安装、分布式执行、配置和评估见 VLA 模型的强化学习后训练 。
通过 Python 调用#
在 Python 中,使用与命令行相同的分发器:
from isaaclab_rl import TrainingRequest, train

train(
    TrainingRequest(
        backend="rsl_rl",
        task="Isaac-Cartpole",
        max_iterations=100,
    )
)
回放时,将 PlaybackRequest 与 play() 配合使用。所选强化学习库理解的选项放入 backend_args ;Hydra 覆盖参数和预设选择器放入 hydra_args 。
故障排除#
内存不足#
首先减小 --num_envs 。这通常能在不改变任务本身的情况下最大程度降低内存用量。对于基于相机的任务,还可考虑减小图像分辨率、采集视图数量、轨迹采样长度或策略规模。
性能测试时禁用交互式可视化器。碰撞几何、接触和可变形物体占用的仿真内存,与策略及轨迹采样缓冲区相互独立。
使用 JAX 时,除仿真内存外,还需考虑其默认显存预分配。
观测或策略中出现 NaN#
NaN 通常源于不稳定的仿真或无效重置状态,随后传播到观测、奖励和学习器中。尽可能在不训练的情况下复现故障,并定位第一个变为非有限值的量。
请检查:
重置时的关节位置、速度和物体位姿;
执行器增益、限制和动作缩放;
接触几何、质量、惯量及异常大的冲量;
物理时间步长、子步数和求解器迭代次数;以及
包含不安全除法、归一化或平方根运算的奖励和观测项。
修复无效状态或计算,而不是通过截断全部策略输入来掩盖问题。然后重新执行训练冒烟测试。
训练稳定,但没有学会任务#
调整超参数前,先验证环境接口约定:
动作控制了预期关节;
观测随环境变化而变化;
智能体取得进展时,奖励增加;以及
终止和重置在预期条件下发生。
与最接近、持续维护的任务配置对照,然后每次只改变一个因素。各实验都应记录任务、强化学习库、物理后端、领域预设、种子、环境数量、智能体配置和 Hydra 覆盖参数。缺少这些信息时,看似细微的配置差异可能被误判为算法性能退化。
检查点无法加载#
确认回放或恢复训练命令使用与原始运行相同的强化学习库、任务、智能体配置、机器学习框架和观测/动作预设。张量形状错误通常意味着其中一项发生了变化。
可用时优先使用 latest 或 best 检查点选择器。清单发现机制会在尝试加载检查点前过滤不兼容的运行。
进一步阅读#
与 RL Agent 进行训练 解释如何为强化学习库包装 Isaac Lab 环境。
配置一个 RL Agent 逐步介绍智能体配置的注册和选择。
Hydra 配置系统 介绍命令行覆盖和参数扫描。
多 GPU 和多节点训练 介绍多 GPU 和多节点训练。
可重现性和确定性 介绍如何开展可复现的实验。
在训练期间采集传感器帧 介绍图像观测的诊断方法。