

控制器#
控制器将期望运动或接触力转换为关节命令。关节空间控制器作用于各个关节,任务空间控制器则作用于末端执行器。
接触任务通常需要一定的柔顺性,以容忍机器人或环境模型的误差 [SSVO09]。常见方法有两种:
阻抗控制: 通过质量—弹簧—阻尼模型建立运动误差与接触力的关系。刚度控制仅使用位置误差与力之间的静态关系。
力/运动混合控制: 在自由方向控制运动,在受约束方向控制力。Isaac Lab 的实现采用操作空间逆动力学 [Kha87]。
选择控制器#
下述核心控制器位于 isaaclab.controllers。Isaac Lab 还提供 Newton 控制器,包含更多控制选项和迭代 IK 求解器。
控制器 |
输入指令 |
输出 |
所需状态 |
|---|---|---|---|
末端执行器的位置或位姿,可使用绝对值或相对增量 |
关节位置目标 |
关节位置,以及在同一坐标系下表示的末端执行器位姿和雅可比矩阵 |
|
末端执行器位姿和/或力旋量,也可包含刚度和阻尼比 |
关节力/力矩 |
雅可比矩阵;运动控制所需的位姿和速度;惯性解耦所需的质量矩阵;以及根据启用功能提供的重力向量、接触力和关节状态 |
基本的关节空间控制直接向执行器设置关节目标。关节空间阻抗控制可使用 JointImpedanceController ,见 关节空间控制器。
使用位置控制执行器进行到达目标或遥操作时,可以先选用微分 IK。需要输出力矩指令、实现任务空间柔顺性,或同时控制运动和接触力时,可选用 OSC。例如,擦拭桌面时,需要沿桌面运动,同时维持沿桌面法向的接触力。
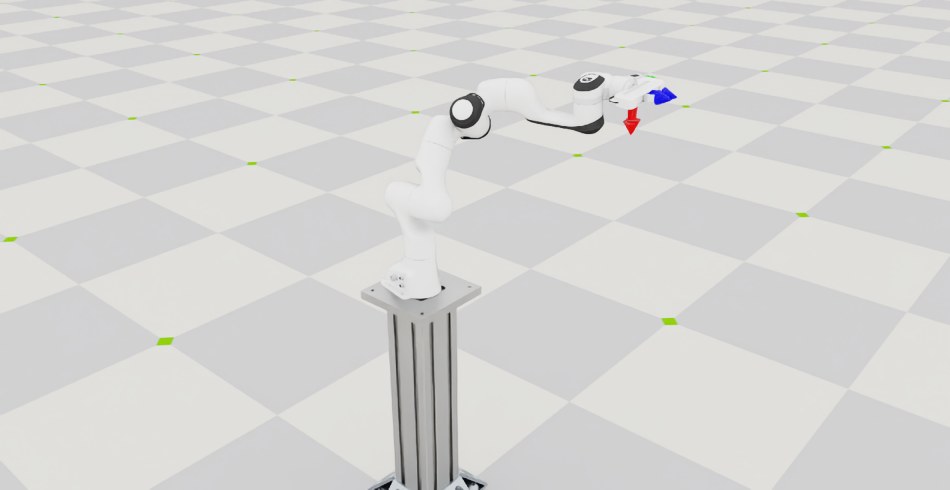
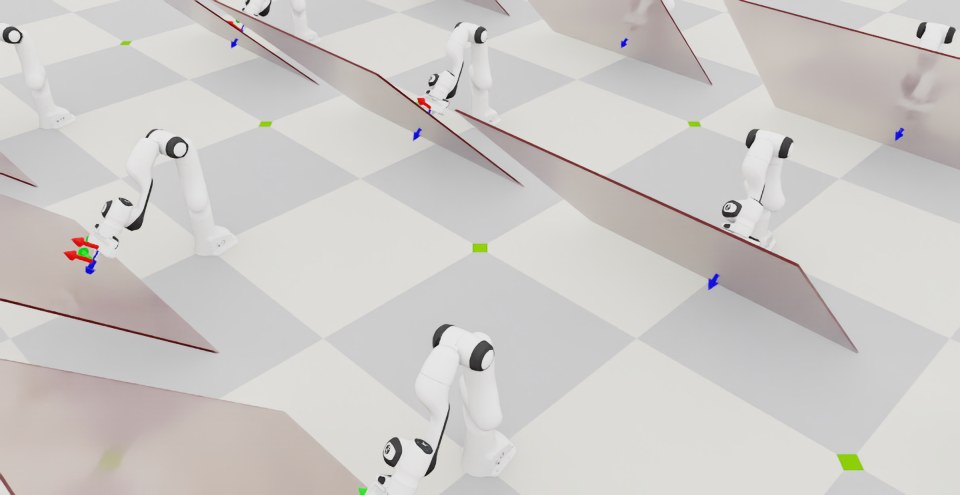
IK 教程 和 OSC 教程 提供了完整场景、状态提取方法和可运行的演示。两个教程脚本均使用 Isaac Sim PhysX,需要安装 Isaac Sim。
Newton 控制器#
isaaclab_newton.controllers 将 Newton 的批量控制器封装为可使用 PyTorch 张量的接口。以下三个控制器均适用于任意物理后端:调用者根据所启用的功能,提供机器人状态、雅可比矩阵和动力学信息,无需 Newton 仿真模型。
微分 IK —
NewtonDifferentialIKController根据末端目标生成关节位置目标,支持轴向权重、自适应阻尼、截断 SVD、关节限位规避和零空间姿态控制。使用NewtonDifferentialIKControllerCfg配置。关节阻抗控制 —
NewtonJointImpedanceController根据期望关节位置和速度生成关节力/力矩,支持惯性解耦、重力与科里奥利力补偿、加速度前馈,以及逐控制步更新增益。使用NewtonJointImpedanceControllerCfg配置。操作空间控制 —
NewtonOperationalSpaceController为任务空间运动和力/力矩控制生成关节力/力矩,支持期望末端速度、分别选择线运动和角运动的坐标系,以及零空间姿态控制。使用NewtonOperationalSpaceControllerCfg配置。
在直接工作流环境中,创建一次控制器,然后在每个控制步向 compute() 传入当前状态和目标,并通过 articulation.actuators 施加返回的关节目标或力/力矩。这些封装具有各自的配置和 compute() 参数,不使用核心控制器的 set_command() API。计算使用 float32,连续的 float32 输入可以零拷贝共享。返回张量引用可复用的输出缓冲区;若需在下一次调用后保留结果,请先克隆。
对于基于管理器的任务,使用 NewtonDifferentialInverseKinematicsActionCfg 或 NewtonOperationalSpaceControllerActionCfg 将相应控制器连接到机器人。例如,以下动作在机器人根坐标系中指定 Franka 手部的绝对位置:
from isaaclab_newton.controllers import NewtonDifferentialIKControllerCfg
from isaaclab_newton.envs.mdp import NewtonDifferentialInverseKinematicsActionCfg

arm_action = NewtonDifferentialInverseKinematicsActionCfg(
    asset_name="robot",
    joint_names=["panda_joint[1-7]"],
    body_name="panda_hand",
    command_type="position",
    controller=NewtonDifferentialIKControllerCfg(
        ik_method="damped_least_squares",
        bandwidth=10.0,
        damping=0.05,
    ),
)
将该项加入任务的动作配置,并使资产、关节和刚体名称与机器人匹配。微分 IK 应使用位置控制执行器,操作空间控制应使用力/力矩控制。
使用 Newton 进行迭代 IK 求解#
NewtonIKSolver 基于 Newton 模型迭代求解位姿目标,而不是利用传入的雅可比矩阵进行单步微分 IK。可以将一个或多个刚体的 NewtonIKPoseObjectiveCfg 目标与 NewtonIKJointLimitObjectiveCfg 组合,以惩罚关节限位违反量。NewtonIKSolverCfg 用于选择 LM 或 L-BFGS 优化、雅可比计算方法、种子采样方式和迭代次数。
使用 NewtonInverseKinematicsActionCfg 可在基于管理器的任务中调用此求解器。目前该动作要求固定基座的关节系统,并已注册 Newton 原型模型;关节和目标刚体必须在 Isaac Lab 与该模型中都能解析。
完整的控制器、求解器和配置 API 见 isaaclab_newton.controllers。
控制循环#
IK 和 OSC 控制器根据调用者提供的状态计算目标值,不会自行读取仿真状态或向执行器发送指令。set_command() 保存目标,直到下一次设置将其替换。每个控制周期都需要读取最新状态、调用 compute()、写入目标,再推进仿真;IK 教程中的循环见 API 使用示例 。IK 输出关节位置目标,由配置的位置执行器跟踪。OSC 输出关节力/力矩目标,因此应将执行器刚度和阻尼设为零,避免执行器的反馈控制额外叠加力/力矩。
指令、末端执行器位姿和雅可比矩阵必须使用一致的坐标系。教程用后缀 _b 表示机器人基座坐标系,用 _w 表示世界坐标系;变量名称本身不会变换数据。绝对位姿由位置和四元数组成,四元数采用 (x, y, z, w) 顺序。OSC 的指令和控制轴选择可以使用单独的任务坐标系,但传入 compute() 的状态仍须在基座坐标系下表示。
关节空间控制器#
没有专门用于选择关节空间控制模式的配置类。控制模式取决于通过 articulation.actuators 设置哪些目标:驱动力目标对应力矩控制,速度目标对应速度控制,位置目标对应位置控制。运行时 API 见 运行时 API: articulation.actuators 。
力矩控制#
动作维度: "n" (关节数量)
在扭矩控制模式下,输入动作被直接设置为前馈关节扭矩命令,即在每个时间步,
速度控制#
动作维度: "n" (关节数量)
在速度控制模式下,需要一个比例控制律来减少当前与期望关节速度之间的误差。基于输入动作,关节扭矩命令计算如下:
在这里 \(k_d\) 是从配置中解析得到的增益。
注意
在执行速度控制时,在许多情况下,需要进行重力补偿以确保更好地跟踪命令。在这种情况下,我们建议在仿真中禁用关节中链节的重力。
位置控制与固定阻抗#
动作维度: "n" (关节数量)
位置控制采用比例—微分(PD)控制律,在目标速度为零的条件下跟踪关节位置:
其中 \(k_p\) 和 \(k_d\) 是从配置中解析出的增益。
考虑关节体动力学后,更完整的表达式为:
其中 \(M\) 是大小为 \(n \times n\) 的关节空间惯性矩阵, \(g\) 是关节空间重力向量。通过将阻抗模式设置为 "fixed" ,可以通过 JointImpedanceController 类来实现此功能。增益 \(k_p\) 从输入配置中解析, \(k_d\) 则在将系统视为解耦的点质量振荡器时计算得出,即,
其中 \(D\) 是系统的阻尼比。当 \(D = 1\) 时,系统达到临界阻尼;当 \(D > 1\) 时,系统为过阻尼;当 \(D < 1\) 时,系统为欠阻尼。
此外,可以通过将配置中的标志 inertial_compensation 和 gravity_compensation 分别设置为 False 来禁用控制器中的惯性补偿或重力补偿。
位置控制与可变刚度#
动作维度: "2n" (关节数)
可变刚度控制使用相同的控制律,但由命令提供 \(k_p\)。将 JointImpedanceController 设为 "variable_kp" 模式即可。
位置控制与可变阻抗#
动作维度: "3n" (关节数)
可变阻抗控制还通过命令提供阻尼。将 JointImpedanceController 设为 "variable" 模式即可。
任务空间控制器#
微分逆运动学 (IK)#
动作维度: "3" (相对/绝对位置), "6" (相对姿态),或 "7" (绝对姿态)
逆运动学将任务空间中的跟踪误差转换为关节空间误差。最常见的实现先计算任务空间位姿误差 \(\Delta \chi_e = (\Delta p_e, \Delta \phi_e)\) :位置误差为目标位置与当前位置之间的笛卡尔距离,姿态误差为目标姿态与当前姿态在 \(\mathbb{SO}(3)\) 中的最短距离。
使用几何雅可比矩阵 \(J_{eO} \in \mathbb{R}^{6 \times n}\) ,它将任务空间的速度与关节空间的速度关联起来,我们设计控制律以获得期望的关节位置,如下所示:
其中 \(\eta\) 是一个缩放参数,而 \(J_{eO}^{-}\) 是雅可比矩阵的伪逆。
可以使用不同的公式计算雅可比矩阵的伪逆:
Moore–Penrose 伪逆(
"pinv"):\(A^{-} = A^T(AA^T)^{-1}\) 。Levenberg–Marquardt 伪逆(阻尼最小二乘法,
"dls"):\(A^{-} = A^T (AA^T + \lambda^2 \mathbb{I})^{-1}\) 。转置法(
"trans"):\(A^{-} = A^T\) 。自适应奇异值分解(SVD)伪逆(
"svd"),见 Buss [Bus04] 。考虑可操作度的阻尼最小二乘法(
"adaptive_dls"):雅可比矩阵接近奇异状态时,增大阻尼 \(\lambda\) 。
这些实现通过 DifferentialIKController 提供。可运行示例见 使用任务空间控制器 。
阻抗控制器#
它利用任务空间位姿误差和雅可比矩阵,通过质量–弹簧–阻尼系统计算关节力矩,支持 a) 固定刚度、b) 可变刚度(刚度控制),以及 c) 可变刚度和阻尼(阻抗控制)。
操作空间控制器#
与任务空间阻抗控制类似,但使用运动方程(EoM)计算任务空间力。可运行示例见 使用操作空间控制器 。
闭环比例力控制器#
它根据末端执行器当前力旋量与目标力旋量的误差,通过比例项跟踪目标力/力矩指令。
混合力-运动控制器#
它结合闭环力控制和操作空间运动控制,计算末端执行器的目标力旋量,并用选择矩阵指定任务中不受约束和受约束的方向。
API 使用示例#
关节目标#
下面分别展示不同类型的指令,假定 robot 已初始化,且 arm_joint_ids 已解析。每个目标张量的形状均为 (num_envs, len(arm_joint_ids))。位置或速度反馈增益在执行器配置中设置;直接控制力/力矩时,应将执行器刚度和阻尼设为零。指令 API 见 运行时 API: articulation.actuators ,增益配置见 执行器 。
joint_pos_target = robot.data.default_joint_pos.torch[:, arm_joint_ids].clone()
robot.actuators.target_command.set_position_index(value=joint_pos_target, joint_ids=arm_joint_ids)
robot.write_data_to_sim()
joint_vel_target = robot.data.default_joint_vel.torch[:, arm_joint_ids].clone()
robot.actuators.target_command.set_velocity_index(value=joint_vel_target, joint_ids=arm_joint_ids)
robot.write_data_to_sim()
import torch

joint_effort_target = torch.zeros_like(robot.data.joint_pos.torch[:, arm_joint_ids])
robot.actuators.target_command.set_effort_index(value=joint_effort_target, joint_ids=arm_joint_ids)
robot.write_data_to_sim()
这些调用先写入待发送指令,再提交给仿真。每个周期还需要推进物理仿真并更新场景,见 控制循环 。
任务空间目标#
IK 教程 每隔 150 步重置机器人并更换目标。其余步读取最新状态并计算关节位置目标;每一步都会应用目标并推进仿真:
if count % 150 == 0:
    # reset time
    count = 0
    # reset joint state
    joint_pos = robot.data.default_joint_pos.torch.clone()
    joint_vel = robot.data.default_joint_vel.torch.clone()
    robot.write_joint_position_to_sim_index(position=joint_pos)
    robot.write_joint_velocity_to_sim_index(velocity=joint_vel)
    robot.reset()
    # reset actions
    ik_commands[:] = ee_goals[current_goal_idx]
    joint_pos_des = joint_pos[:, robot_entity_cfg.joint_ids].clone()
    # reset controller
    diff_ik_controller.reset()
    diff_ik_controller.set_command(ik_commands)
    # change goal
    current_goal_idx = (current_goal_idx + 1) % len(ee_goals)
else:
    # obtain quantities from simulation. The Jacobian DoF axis prepends
    # ``num_base_dofs`` floating-base columns (0 for fixed-base, 6 for
    # floating-base); shift the actuated-joint ids accordingly.
    jacobi_joint_ids = [j + robot.num_base_dofs for j in robot_entity_cfg.joint_ids]
    jacobian = robot.data.body_link_jacobian_w.torch[:, ee_jacobi_idx, :, jacobi_joint_ids]
    ee_pose_w = robot.data.body_pose_w.torch[:, robot_entity_cfg.body_ids[0]]
    root_pose_w = robot.data.root_pose_w.torch
    joint_pos = robot.data.joint_pos.torch[:, robot_entity_cfg.joint_ids]
    # compute frame in root frame
    ee_pos_b, ee_quat_b = subtract_frame_transforms(
        root_pose_w[:, 0:3], root_pose_w[:, 3:7], ee_pose_w[:, 0:3], ee_pose_w[:, 3:7]
    )
    # compute the joint commands
    joint_pos_des = diff_ik_controller.compute(ee_pos_b, ee_quat_b, jacobian, joint_pos)

# apply actions
robot.set_joint_position_target_index(target=joint_pos_des, joint_ids=robot_entity_cfg.joint_ids)
scene.write_data_to_sim()
# perform step
sim.step()
# update sim-time
count += 1
# update buffers
scene.update(sim_dt)
使用相对指令时,DifferentialIKController.set_command() 还需要接收测得的位姿,以便在设置指令时解析相对增量。
OperationalSpaceController 实例 osc 同样通过 OperationalSpaceController.set_command() 保存运动/力目标,但 OperationalSpaceController.compute() 返回的是力/力矩,需要用 set_effort_index 写入。所需状态取决于启用的功能。控制器创建、状态提取和完整循环见 IK 教程 与 OSC 教程 。
反应式规划器#
任务空间控制器通常由 RRT 等上层规划器处理关节限位和避碰。反应式规划器则可将这些约束直接纳入运动与控制的优化计算。
反应式规划器的示例包括:
RMPFlow (lula): 一种基于加速度的策略,通过组合各种黎曼运动策略(RMPs)来解决任务层次结构 [CMI+21] 。它能够在将末端执行器导航到目标的同时执行动态避碰。
MPC(OCS2): 基于序贯线性二次(SLQ)规划的滚动时域控制策略。它通过软惩罚将各类约束纳入同一优化问题,并使用自动微分计算系统动力学、约束和代价的导数。 [MHF+22] 中用于固定机械臂和移动操作机器人末端轨迹跟踪的 MPC 采用运动学系统模型,考虑关节限位和自碰撞规避。外部工具包和示例见 OCS2 文档 。
警告
RmpFlowController 包装基于 CPU 的 Lula 绑定,因此大批量计算时可能限制吞吐量。它还需要 Lula 库和机器人描述文件;这些依赖与所选物理后端相互独立。