

USD 环境中的策略推理#
本部署示例在预先构建的 USD 场景中运行已训练策略,沿用训练任务的观测、动作和机器人配置。
本教程使用 RSL RL 库,将人形机器人崎岖地形任务 Isaac-Velocity-Rough-H1 的已训练策略运行在一个简单的仓库 USD 场景中。
教程代码#
对于本教程,我们使用训练好的策略的检查点,导出为 jit(这是策略的离线版本)。
脚本通过 parse_env_cfg 解析 H1RoughEnvCfg ,包括命令行传入的物理预设。调用配置的 play_mode 方法,会在训练配置之上应用回放和推理覆盖项,例如减少环境数量、禁用观测噪声。
为了使用预构建的 USD 环境而不是指定的地形生成器,我们在将其传递给 ManagerBasedRLEnv 之前对配置进行以下更改。
policy_inference_in_usd.py 的代码
 1# Copyright (c) 2022-2026, The Isaac Lab Project Developers (https://github.com/isaac-sim/IsaacLab/blob/main/CONTRIBUTORS.md).
 2# All rights reserved.
 3#
 4# SPDX-License-Identifier: BSD-3-Clause
 5
 6"""
 7This script demonstrates policy inference in a prebuilt USD environment.
 8
 9In this example, we use a locomotion policy to control the H1 robot. The robot was trained
10using Isaac-Velocity-Rough-H1. The robot is commanded to move forward at a constant velocity.
11
12.. code-block:: bash
13
14    # Run the script
15    uv run python scripts/tutorials/03_envs/policy_inference_in_usd.py --checkpoint /path/to/jit/checkpoint.pt
16
17"""
18
19import argparse
20
21from isaaclab.app import add_launcher_args, launch_simulation
22from isaaclab.utils import instantiate
23
24# add argparse arguments
25parser = argparse.ArgumentParser(description="Tutorial on inferencing a policy on an H1 robot in a warehouse.")
26parser.add_argument("--checkpoint", type=str, help="Path to model checkpoint exported as jit.", required=True)
27
28add_launcher_args(parser)
29# parse the arguments, forwarding unrecognized ones as Hydra-style task config overrides
30args_cli, hydra_overrides = parser.parse_known_args()
31
32import os
33
34import torch
35
36from isaaclab.terrains import TerrainImporterCfg
37from isaaclab.utils.assets import ISAAC_NUCLEUS_DIR, read_file
38
39from isaaclab_tasks.utils import parse_env_cfg
40
41
42def main():
43    """Main function."""
44    # load the trained jit policy
45    policy_path = os.path.abspath(args_cli.checkpoint)
46    file = read_file(policy_path)
47    policy = torch.jit.load(file, map_location=args_cli.device)
48
49    # setup environment
50    env_cfg = parse_env_cfg("Isaac-Velocity-Rough-H1", device=args_cli.device, num_envs=1, overrides=hydra_overrides)
51    env_cfg.play_mode()
52    env_cfg.curriculum = None
53    env_cfg.scene.terrain = TerrainImporterCfg(
54        prim_path="/World/ground",
55        terrain_type="usd",
56        usd_path=f"{ISAAC_NUCLEUS_DIR}/Environments/Simple_Warehouse/warehouse.usd",
57    )
58    # The warehouse is enclosed: start the height-scan rays below its roof so they hit the floor.
59    env_cfg.scene.height_scanner.offset.pos = (0.0, 0.0, 2.0)
60    if args_cli.device == "cpu":
61        env_cfg.sim.use_fabric = False
62
63    with launch_simulation(env_cfg, args_cli):
64        # create environment
65        env = instantiate(env_cfg)
66
67        # run inference with the policy
68        obs, _ = env.reset()
69        with torch.inference_mode():
70            while env.sim.is_running():
71                action = policy(obs["policy"])
72                obs, _, _, _, _ = env.step(action)
73        env.close()
74
75
76if __name__ == "__main__":
77    main()
脚本对策略加载和仿真都使用 --device 指定的设备。只有显式选择 --device cpu 时,才禁用 Fabric。高度扫描器从仓库屋顶下方发射射线,使向下的射线测量地面。
训练、导出和推理应使用相同的物理预设。以下命令使用 Newton MJWarp 和 newton_gl 可视化器,无需 Isaac Sim。对于使用 Isaac Sim 训练的 PhysX 检查点,应在整个流程中使用 physics=isaacsim_physx 并安装 Isaac Sim;仍可使用 Newton GL 查看器。跨后端策略迁移需要额外验证,参见 在 PhysX 和 Newton 之间迁移策略 。
代码执行#
首先运行以下命令,训练 Isaac-Velocity-Rough-H1 任务:
uv run isaaclab train --rl_library rsl_rl --task Isaac-Velocity-Rough-H1 physics=newton_mjwarp
./isaaclab.sh train --rl_library rsl_rl --task Isaac-Velocity-Rough-H1 physics=newton_mjwarp
当训练完成时,我们可以使用以下命令可视化结果。要停止仿真,您可以关闭窗口,或者在启动仿真的终端中按下 Ctrl+C 。
uv run isaaclab play --rl_library rsl_rl --task Isaac-Velocity-Rough-H1 physics=newton_mjwarp --num_envs 64 --checkpoint logs/rsl_rl/h1_rough/EXPERIMENT_NAME/POLICY_FILE.pt --viz newton_gl
./isaaclab.sh play --rl_library rsl_rl --task Isaac-Velocity-Rough-H1 physics=newton_mjwarp --num_envs 64 --checkpoint logs/rsl_rl/h1_rough/EXPERIMENT_NAME/POLICY_FILE.pt --viz newton_gl
运行播放脚本后,策略将被导出为 jit 和 onnx 文件,存储在实验日志目录下。请注意,并非所有学习库都支持将策略导出为 jit 或 onnx 文件。对于当前不支持此功能的库,请参考相应的 play.py 脚本,以了解如何初始化策略。
我们可以加载仓库资产,并使用导出的 jit 策略在 H1 机器人上运行推理 (policy.pt 文件在 exported/ 路径下)。
uv run python scripts/tutorials/03_envs/policy_inference_in_usd.py --checkpoint logs/rsl_rl/h1_rough/EXPERIMENT_NAME/exported/policy.pt physics=newton_mjwarp --viz newton_gl
./isaaclab.sh -p scripts/tutorials/03_envs/policy_inference_in_usd.py --checkpoint logs/rsl_rl/h1_rough/EXPERIMENT_NAME/exported/policy.pt physics=newton_mjwarp --viz newton_gl
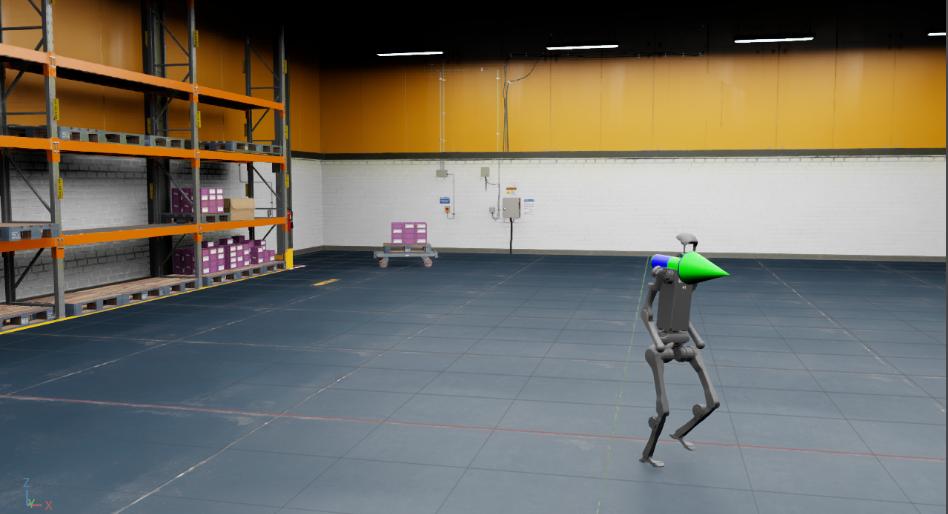
在本教程中,我们学习了如何对现有环境配置进行一些小修改,以在预构建的 usd 环境中运行策略推理。