

参见
本教程是 isaaclab-randomizing-with-events 智能体技能的权威依据( skills/user/domain-randomization-events/ )。修改本页时,也应更新该技能,使智能体指导保持同步。参见 智能体技能 。
创建基于管理器的基础环境#
环境将仿真的不同方面,如场景、观测和行动空间、重置事件等集合在一起,为各种应用程序创建一个连贯的接口。在 Isaac Lab 中,基于管理器的环境被实现为: envs.ManagerBasedEnv 和 envs.ManagerBasedRLEnv 类。这两个类非常相似,但 envs.ManagerBasedRLEnv 对强化学习任务很有用,并包含奖励、中止、课程表和命令生成。 envs.ManagerBasedEnv 类适用于传统的机器人控制,不包含奖励和中止条件。
在本教程中,我们将研究基础类:envs.ManagerBasedEnv 及其对应的配置类:envs.ManagerBasedEnvCfg ,用于基于管理器的工作流程。我们将使用之前的 cartpole 环境来说明创建新的 envs.ManagerBasedEnv 环境中的不同组件。
代码#
此教程对应于 scripts/tutorials/03_envs 目录中的 create_cartpole_base_env 脚本。
create_cartpole_base_env.py 的代码
  1# Copyright (c) 2022-2026, The Isaac Lab Project Developers (https://github.com/isaac-sim/IsaacLab/blob/main/CONTRIBUTORS.md).
  2# All rights reserved.
  3#
  4# SPDX-License-Identifier: BSD-3-Clause
  5
  6"""
  7This script demonstrates how to create a simple environment with a cartpole. It combines the concepts of
  8scene, action, observation and event managers to create an environment.
  9
 10.. code-block:: bash
 11
 12    uv run python scripts/tutorials/03_envs/create_cartpole_base_env.py --num_envs 32
 13
 14"""
 15
 16"""Parse the command-line arguments first."""
 17
 18
 19import argparse
 20
 21from isaaclab.app import add_launcher_args, launch_simulation
 22
 23# add argparse arguments
 24parser = argparse.ArgumentParser(description="Tutorial on creating a cartpole base environment.")
 25parser.add_argument("--num_envs", type=int, default=16, help="Number of environments to spawn.")
 26
 27# append simulation launcher cli args
 28add_launcher_args(parser)
 29# parse the arguments
 30args_cli = parser.parse_args()
 31
 32"""Rest everything follows."""
 33
 34import math
 35
 36import torch
 37
 38import isaaclab.envs.mdp as mdp
 39from isaaclab.envs import ManagerBasedEnvCfg
 40from isaaclab.managers import EventTermCfg as EventTerm
 41from isaaclab.managers import ObservationGroupCfg as ObsGroup
 42from isaaclab.managers import ObservationTermCfg as ObsTerm
 43from isaaclab.managers import SceneEntityCfg
 44from isaaclab.utils import configclass, instantiate
 45from isaaclab.visualizers import VisualizerCfg
 46
 47from isaaclab_tasks.core.cartpole.cartpole_manager_env_cfg import CartpoleSceneCfg
 48
 49
 50@configclass
 51class ActionsCfg:
 52    """Action specifications for the environment."""
 53
 54    joint_efforts = mdp.JointEffortActionCfg(asset_name="robot", joint_names=["slider_to_cart"], scale=5.0)
 55
 56
 57@configclass
 58class ObservationsCfg:
 59    """Observation specifications for the environment."""
 60
 61    @configclass
 62    class PolicyCfg(ObsGroup):
 63        """Observations for policy group."""
 64
 65        # observation terms (order preserved)
 66        joint_pos_rel = ObsTerm(func=mdp.joint_pos_rel)
 67        joint_vel_rel = ObsTerm(func=mdp.joint_vel_rel)
 68
 69        def __post_init__(self) -> None:
 70            self.enable_corruption = False
 71            self.concatenate_terms = True
 72
 73    # observation groups
 74    policy: PolicyCfg = PolicyCfg()
 75
 76
 77@configclass
 78class EventCfg:
 79    """Configuration for events."""
 80
 81    # on startup
 82    add_pole_mass = EventTerm(
 83        func=mdp.randomize_rigid_body_mass,
 84        mode="startup",
 85        params={
 86            "asset_cfg": SceneEntityCfg("robot", body_names=["pole"]),
 87            "mass_distribution_params": (0.1, 0.5),
 88            "operation": "add",
 89        },
 90    )
 91
 92    # on reset
 93    reset_cart_position = EventTerm(
 94        func=mdp.reset_joints_by_offset,
 95        mode="reset",
 96        params={
 97            "asset_cfg": SceneEntityCfg("robot", joint_names=["slider_to_cart"]),
 98            "position_range": (-1.0, 1.0),
 99            "velocity_range": (-0.1, 0.1),
100        },
101    )
102
103    reset_pole_position = EventTerm(
104        func=mdp.reset_joints_by_offset,
105        mode="reset",
106        params={
107            "asset_cfg": SceneEntityCfg("robot", joint_names=["cart_to_pole"]),
108            "position_range": (-0.125 * math.pi, 0.125 * math.pi),
109            "velocity_range": (-0.01 * math.pi, 0.01 * math.pi),
110        },
111    )
112
113
114@configclass
115class CartpoleEnvCfg(ManagerBasedEnvCfg):
116    """Configuration for the cartpole environment."""
117
118    # Scene settings
119    scene = CartpoleSceneCfg(num_envs=1024, env_spacing=2.5)
120    # Basic settings
121    observations = ObservationsCfg()
122    actions = ActionsCfg()
123    events = EventCfg()
124
125    def __post_init__(self):
126        """Post initialization."""
127        # viewer settings
128        self.sim.default_visualizer_cfg = VisualizerCfg(eye=(4.5, 0.0, 6.0), lookat=(0.0, 0.0, 2.0))
129        # step settings
130        self.decimation = 4  # env step every 4 sim steps: 200Hz / 4 = 50Hz
131        # simulation settings
132        self.sim.dt = 0.005  # sim step every 5ms: 200Hz
133
134
135def main():
136    """Main function."""
137    # parse the arguments
138    env_cfg = CartpoleEnvCfg()
139    env_cfg.scene.num_envs = args_cli.num_envs
140    env_cfg.sim.device = args_cli.device
141    # Launch the simulator runtime that the configuration needs
142    with launch_simulation(env_cfg, args_cli):
143        # setup base environment
144        env = instantiate(env_cfg)
145
146        # simulate physics
147        count = 0
148        while env.sim.is_running():
149            with torch.inference_mode():
150                # reset
151                if count % 300 == 0:
152                    count = 0
153                    env.reset()
154                    print("-" * 80)
155                    print("[INFO]: Resetting environment...")
156                # sample random actions
157                joint_efforts = torch.randn_like(env.action_manager.action)
158                # step the environment
159                obs, _ = env.step(joint_efforts)
160                # print current orientation of pole
161                print("[Env 0]: Pole joint: ", obs["policy"][0][1].item())
162                # update counter
163                count += 1
164
165        # close the environment
166        env.close()
167
168
169if __name__ == "__main__":
170    # run the main function
171    main()
代码解释#
envs.ManagerBasedEnv 基类包含了仿真交互的许多复杂性,并为用户提供了一个简单的接口来运行仿真并与其交互。它由以下组件组成:
scene.InteractiveScene- 用于仿真的场景。managers.ActionManager- 处理动作的管理器。managers.ObservationManager- 处理观测的管理器。managers.EventManager- 安排操作(例如域随机化)在指定的仿真事件上执行。例如,启动时,重置时或定期间隔。
通过配置这些组件,用户可以以最小的工作量创建相同环境的不同变体。在本教程中,我们将浏览 envs.ManagerBasedEnv 类的不同组件以及如何配置它们来创建新环境。
设计场景#
创建新环境的第一步是配置其场景。对于 cartpole 环境,我们将使用前一个教程中的场景。因此,我们在这里省略场景配置。有关如何配置场景的更多详细信息,请参阅: 使用交互式场景 。
定义 actions#
上一教程通过 robot.actuators.target_command.set_effort_index ,直接向倒立摆输入动作。本教程将使用 managers.ActionManager 处理动作。
动作管理器可以包括多个 managers.ActionTerm 。每个动作项负责对环境的特定方面进行*控制* 。例如,对于机器人手臂,我们可以有两个动作项--一个用于控制手臂的关节,另一个用于控制夹爪。这种组合允许用户为环境的不同方面定义不同的控制方案。
在 cartpole 环境中,我们希望控制施加在小车上的力以平衡杆。因此,我们将创建一个动作项来控制施加在小车上的力。
@configclass
class ActionsCfg:
    """Action specifications for the environment."""

    joint_efforts = mdp.JointEffortActionCfg(asset_name="robot", joint_names=["slider_to_cart"], scale=5.0)
定义观测#
虽然场景定义了环境的状态,但观测定义了智能体可以观察到的状态。智能体使用这些观测来决定采取什么行动。在 Isaac Lab 中,观测由 managers.ObservationManager 类计算。
与动作管理器类似,观测管理器可以包含多个观测项。这些进一步分组为观测组,用于定义环境的不同观测空间。例如,对于分层控制,我们可能想定义两个观测组--一个用于低级控制器,另一个用于高级控制器。这些项假定在组中的所有观测项具有相同的维度。
对于本教程,我们只定义了一个名为 "policy" 的观测组。虽然不是完全具体的,但这个组对于 Isaac Lab 中的各种包装来说是一个必要的要求。我们通过继承 managers.ObservationGroupCfg 类来定义一个组。这个类收集不同的观测项,并帮助定义组的公共属性,比如启用噪声损坏或将观测项连接成一个张量。
通过继承 managers.ObservationTermCfg 类来定义单独的项。这个类采用了 managers.ObservationTermCfg.func ,它指定了用于计算该项观测的函数或可调用类。它包括用于定义噪声模型、剪切、缩放等的其他参数。然而,对于本教程,我们将这些参数保留为其默认值。
@configclass
class ObservationsCfg:
    """Observation specifications for the environment."""

    @configclass
    class PolicyCfg(ObsGroup):
        """Observations for policy group."""

        # observation terms (order preserved)
        joint_pos_rel = ObsTerm(func=mdp.joint_pos_rel)
        joint_vel_rel = ObsTerm(func=mdp.joint_vel_rel)

        def __post_init__(self) -> None:
            self.enable_corruption = False
            self.concatenate_terms = True

    # observation groups
    policy: PolicyCfg = PolicyCfg()
如果策略需要展平的历史观测,并希望每个时间步的所有观测项排列在一起,应在其 managers.ObservationGroupCfg 中设置 history_length 和 history_order="time" 。所得观测形状为 (num_envs, history_length * combined_term_dim) ,可重塑为 (num_envs, history_length, combined_term_dim) 。默认的 "term" 顺序将每个观测项的历史排列在一起;对于按原有布局训练的策略,应继续使用这一顺序。
定义事件#
此时,我们已经为 cartpole 环境定义了场景、动作和观测。所有这些组件的一般思想是定义配置类,然后将它们传递给相应的管理器。事件管理器也不例外。
managers.EventManager 类负责对应于仿真状态的更改的事件。这包括重置(或随机化)场景、随机化物理特性(如质量、摩擦等)以及改变视觉特性(如颜色、纹理等)。每个事件都通过 managers.EventTermCfg 类来指定,该类采用 managers.EventTermCfg.func 来指定执行事件的函数或可调用类。
此外,它期望事件的 模式 。这个模式指定事件项应何时应用。可以指定自己的模式。为此,您需要调整 ManagerBasedEnv 类。但是,Isaac Lab 提供了三种常用的模式:
"startup"— 启动事件,仅在环境启动时执行一次。"reset"— 重置事件,在环境终止并重置时执行。"interval"— 间隔事件,每隔指定步数周期性执行。
对于此示例,我们定义了在启动时随机化杆的质量的事件。这只发生一次,因为此操作很昂贵,我们不希望在每次重置时都进行。我们还创建了一个事件,以在每次重置时随机化小车和杆的初始关节状态。
@configclass
class EventCfg:
    """Configuration for events."""

    # on startup
    add_pole_mass = EventTerm(
        func=mdp.randomize_rigid_body_mass,
        mode="startup",
        params={
            "asset_cfg": SceneEntityCfg("robot", body_names=["pole"]),
            "mass_distribution_params": (0.1, 0.5),
            "operation": "add",
        },
    )

    # on reset
    reset_cart_position = EventTerm(
        func=mdp.reset_joints_by_offset,
        mode="reset",
        params={
            "asset_cfg": SceneEntityCfg("robot", joint_names=["slider_to_cart"]),
            "position_range": (-1.0, 1.0),
            "velocity_range": (-0.1, 0.1),
        },
    )

    reset_pole_position = EventTerm(
        func=mdp.reset_joints_by_offset,
        mode="reset",
        params={
            "asset_cfg": SceneEntityCfg("robot", joint_names=["cart_to_pole"]),
            "position_range": (-0.125 * math.pi, 0.125 * math.pi),
            "velocity_range": (-0.01 * math.pi, 0.01 * math.pi),
        },
    )
将所有内容联系起来#
定义了场景和管理器配置之后,我们现在可以通过 envs.ManagerBasedEnvCfg 类定义环境配置。这个类接受场景、动作、观测和事件配置。
除此之外,它还接收了 envs.ManagerBasedEnvCfg.sim ,它定义了仿真参数,如时间步长、重力等。这些参数被初始化为默认值,但可以根据需要进行修改。我们建议通过在 envs.ManagerBasedEnvCfg 类中定义 __post_init__() 方法来实现,该方法在配置初始化后被调用。
@configclass
class CartpoleEnvCfg(ManagerBasedEnvCfg):
    """Configuration for the cartpole environment."""

    # Scene settings
    scene = CartpoleSceneCfg(num_envs=1024, env_spacing=2.5)
    # Basic settings
    observations = ObservationsCfg()
    actions = ActionsCfg()
    events = EventCfg()

    def __post_init__(self):
        """Post initialization."""
        # viewer settings
        self.sim.default_visualizer_cfg = VisualizerCfg(eye=(4.5, 0.0, 6.0), lookat=(0.0, 0.0, 2.0))
        # step settings
        self.decimation = 4  # env step every 4 sim steps: 200Hz / 4 = 50Hz
        # simulation settings
        self.sim.dt = 0.005  # sim step every 5ms: 200Hz
运行仿真#
最后,我们再次访问仿真执行循环。现在,这非常简单,因为我们已经抽象出大部分细节到环境配置中。我们只需要调用 envs.ManagerBasedEnv.reset() 方法来重置环境,以及在 envs.ManagerBasedEnv.step() 方法中步进环境。这两个函数都会返回观测和信息字典,后者可能包含环境提供的其他信息。智能体可以使用这些信息做决策。
创建环境前,将其配置传给 app.launch_simulation() 。该函数启动配置所需的仿真器运行时,并在离开 with 块时关闭它。代码块内, instantiate() 根据配置的 class_type 属性所指定的类构建环境。类采用延迟解析,因此操作 USD 舞台的环境类只会在运行时启动后导入。
envs.ManagerBasedEnv 类没有任何中止概念,因为该概念对于周期性任务是特定的。因此,用户需要负责为环境定义终止条件。在本教程中,我们定期重置仿真。
def main():
    """Main function."""
    # parse the arguments
    env_cfg = CartpoleEnvCfg()
    env_cfg.scene.num_envs = args_cli.num_envs
    env_cfg.sim.device = args_cli.device
    # Launch the simulator runtime that the configuration needs
    with launch_simulation(env_cfg, args_cli):
        # setup base environment
        env = instantiate(env_cfg)

        # simulate physics
        count = 0
        while env.sim.is_running():
            with torch.inference_mode():
                # reset
                if count % 300 == 0:
                    count = 0
                    env.reset()
                    print("-" * 80)
                    print("[INFO]: Resetting environment...")
                # sample random actions
                joint_efforts = torch.randn_like(env.action_manager.action)
                # step the environment
                obs, _ = env.step(joint_efforts)
                # print current orientation of pole
                print("[Env 0]: Pole joint: ", obs["policy"][0][1].item())
                # update counter
                count += 1

        # close the environment
        env.close()
上面需要注意的一个重要事项是整个仿真循环包含在 torch.inference_mode() 上下文管理器中。这是因为环境在幕后使用 PyTorch 操作,我们希望确保仿真不会因 PyTorch 的自动求导引擎的开销而变慢,也不会为仿真操作计算梯度。
代码执行#
运行此教程中创建的基本环境,您可以使用以下命令:
uv run python scripts/tutorials/03_envs/create_cartpole_base_env.py --num_envs 32 --viz kit
./isaaclab.sh -p scripts/tutorials/03_envs/create_cartpole_base_env.py --num_envs 32 --viz kit
这会打开一个具有地平面、光源和 cartpoles 的场景。仿真应该正在进行中,并对 cartpole 进行随机动作。此外,它还在屏幕右下角打开一个名为 "Isaac Lab" 的 UI 窗口。此窗口包含不同的 UI 元素,可用于调试和可视化。
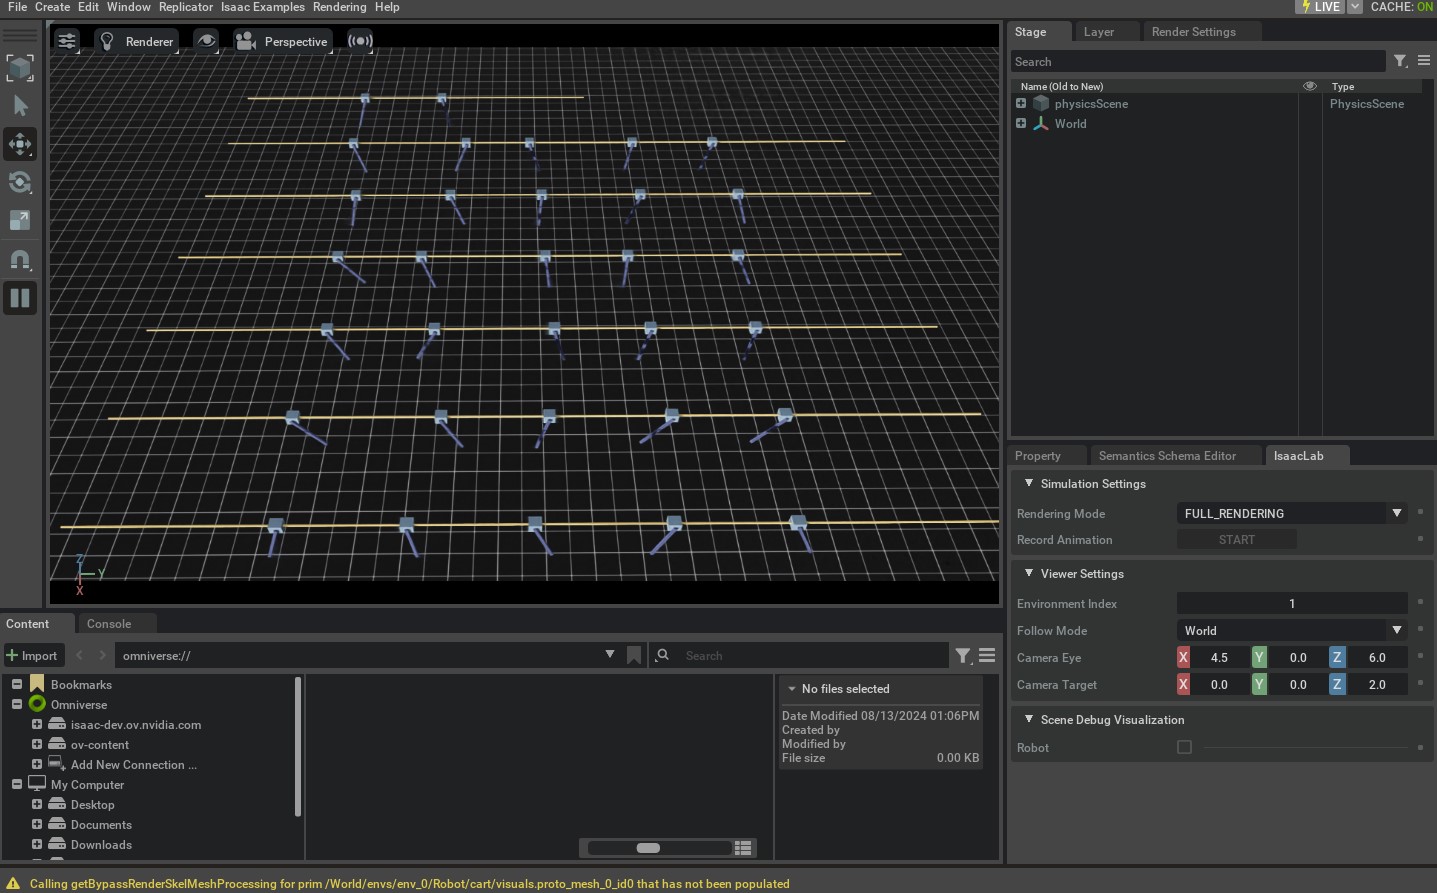
要停止仿真,您可以关闭窗口,或者在启动仿真的终端中按 Ctrl+C 。
在这个教程中,我们学习了不同的管理器,来帮助定义基础环境。我们还在 scripts/tutorials/03_envs 目录中包含了更多定义基础环境的示例。为了完整起见,可以使用以下命令来运行它们:
# Floating cube environment with custom action term for PD control
uv run python scripts/tutorials/03_envs/create_cube_base_env.py --num_envs 32 --viz kit

# Quadrupedal locomotion environment with a policy that interacts with the environment
uv run python scripts/tutorials/03_envs/create_quadruped_base_env.py --num_envs 32 --viz kit
# Floating cube environment with custom action term for PD control
./isaaclab.sh -p scripts/tutorials/03_envs/create_cube_base_env.py --num_envs 32 --viz kit

# Quadrupedal locomotion environment with a policy that interacts with the environment
./isaaclab.sh -p scripts/tutorials/03_envs/create_quadruped_base_env.py --num_envs 32 --viz kit
在接下来的教程中,我们将看看 envs.ManagerBasedRLEnv 类以及如何使用它来创建马尔可夫决策过程(MDP)。